理解与可视化卷积神经网络
(本页原文仍为草稿。)
将卷积网络学到的内容可视化
已有研究提出了多种理解和可视化卷积网络的方法,部分是为了回应“神经网络学到的特征难以解释”这一常见质疑。本节简要介绍其中一些方法及相关研究。
激活值与第一层权重的可视化
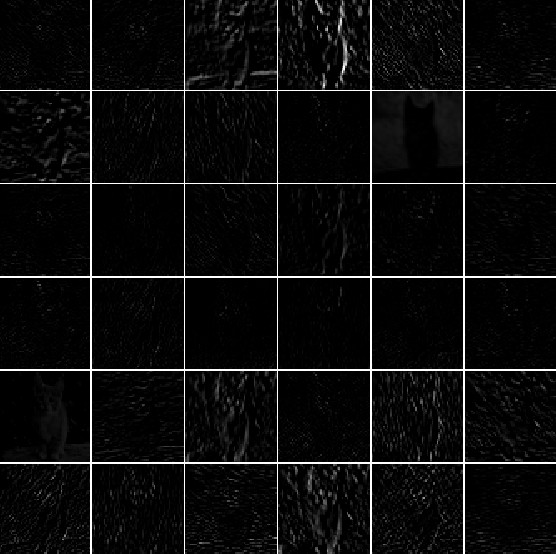
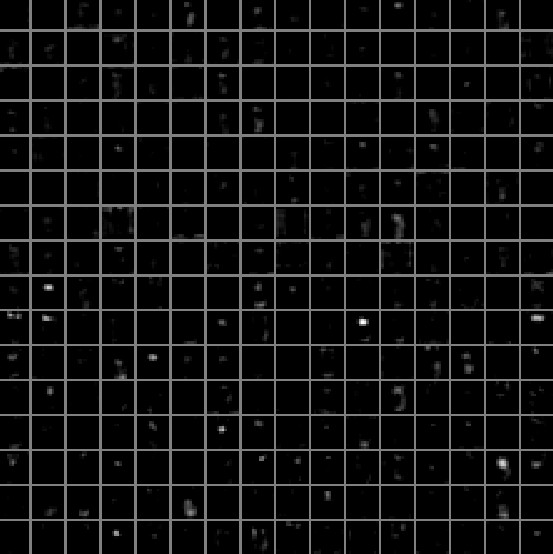
各层激活值。最直接的可视化方式是展示前向传播中的激活值。对于 ReLU 网络,训练初期的激活通常较密集、呈团块状;随着训练推进,会逐渐变得稀疏并集中在局部。一个值得警惕的现象是:某些激活图面对许多不同输入时始终全为 0。这可能说明相应滤波器已经失活,也可能是学习率过高的表现。
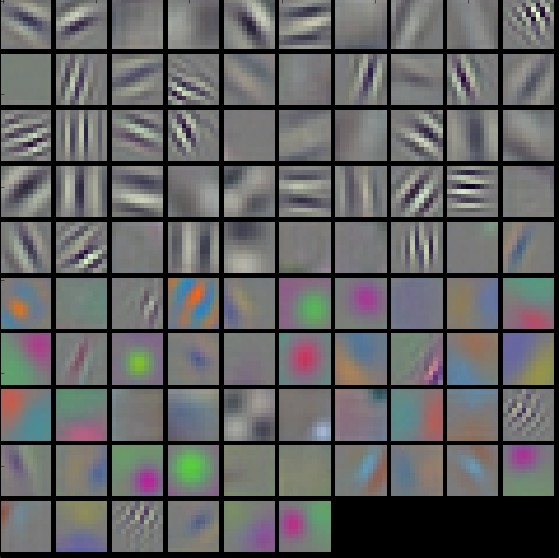
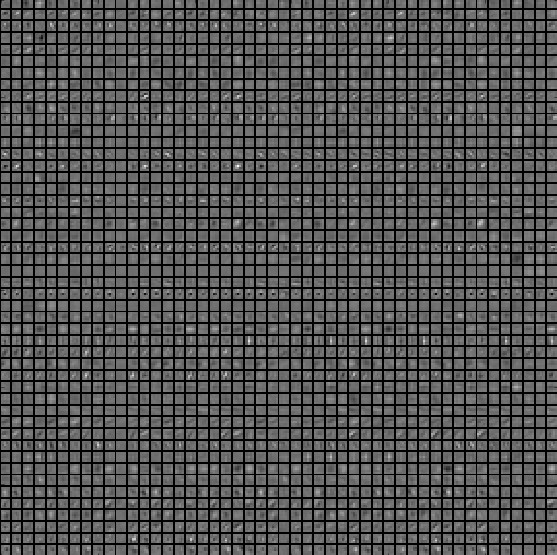
卷积层/全连接层的滤波器。另一种常见方法是可视化权重。直接接收原始像素的第一卷积层最容易解释,也可以展示更深层的滤波器权重。训练充分的网络通常具有平滑、结构清晰、没有明显噪声的滤波器;出现噪声图样可能意味着训练不足,也可能是正则化强度过低而产生了过拟合。
检索最能激活某个神经元的图像
还可以将大量图像输入网络,记录哪些图像最能激活某个神经元,再观察这些图像,理解该神经元在感受野中寻找什么特征。Ross Girshick 等人的《用于精确目标检测与语义分割的丰富特征层次》展示了此类可视化:
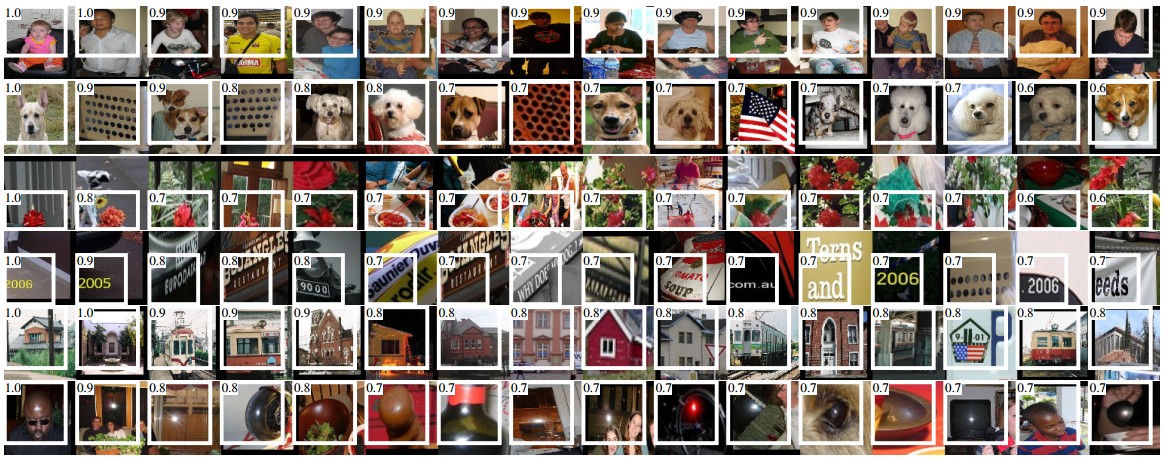
这一方法的局限是,单个 ReLU 神经元未必具有独立、明确的语义。更合适的理解是:多个 ReLU 神经元构成表示图像块的空间的一组基向量。上述可视化展示的是表示分布沿滤波器权重所对应的某些坐标轴方向上的极端图像块,而坐标轴本身可以是任意的。从线性表示的角度看,旋转这一空间的坐标系并不会改变其本质。Szegedy 等人在《神经网络的一些有趣性质》中进一步讨论了这一点,并沿表示空间中的任意方向进行了类似可视化。
使用 t-SNE 嵌入网络特征
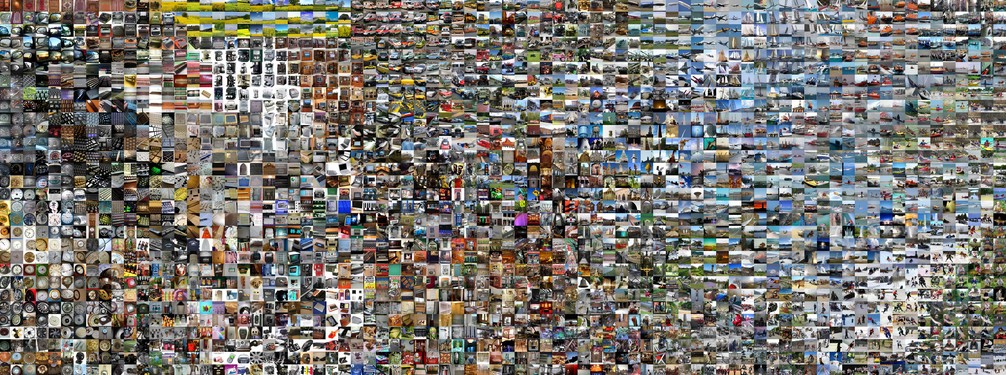
卷积网络可以理解为逐步把图像变换到一个便于线性分类的表示空间。把图像嵌入二维,并尽量保留高维表示中的距离关系,就能粗略观察这个空间的结构。许多降维嵌入方法都试图在低维空间中保持样本的两两距离;其中 t-SNE 是广为人知、通常具有较好可视化效果的方法。
具体做法是选取一组图像,用卷积网络提取 CNN 特征编码,例如 AlexNet 分类器之前的 4096 维向量,并保留 ReLU 非线性处理。然后将这些向量输入 t-SNE,为每张图像得到二维坐标,再将对应图像排布在平面上:
遮挡图像局部区域
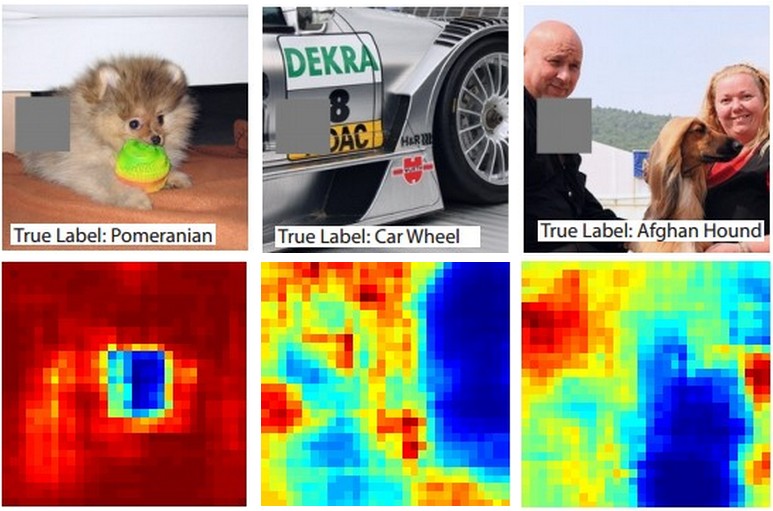
当网络把一张图像判为狗时,如何确定它确实识别了狗,而不是利用背景或其他物体作为线索?可以用遮挡物依次遮住图像的不同区域,将该区域置零,记录目标类别(例如狗)的预测概率,再把概率随遮挡位置的变化画成二维热力图。Matthew Zeiler 的《可视化并理解卷积网络》使用了这一方法:
输入梯度及相关方法的可视化
输入数据梯度。
反卷积网络(DeconvNet)。
引导反向传播。
根据 CNN 特征重建原始图像
保留了多少空间信息?
《卷积网络是否学到了对应关系?》(简要结论:是。)