优化:随机梯度下降
本篇目录:
引言
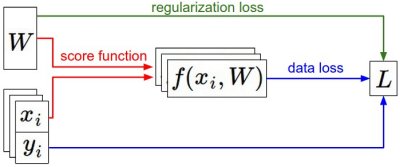
在上一节中,我们介绍了图像分类任务中的两个关键组件:
- 将原始图像像素映射到类别得分的(参数化)得分函数(例如线性函数)
- 损失函数,根据诱导分数与训练数据中的真实标签的一致程度来衡量特定参数集的质量。我们看到有很多方法和版本(例如 Softmax/SVM)。
具体来说,回想一下线性函数的形式为 \\( f(x_i, W) = W x_i \\),我们开发的 SVM 公式为:
$$ L = \frac{1}{N} \sum_i \sum_{j\neq y_i} \left[ \max(0, f(x_i; W)_j - f(x_i; W)_{y_i} + 1) \right] + \alpha R(W) $$
我们看到参数 \\(W\\) 的设置可以产生与地面真实标签 \\(y_i\\) 一致的示例 \\(x_i\\) 的预测,也将具有非常低的损失 \\(L\\)。我们现在要介绍第三个也是最后一个关键组件:优化。优化是找到最小化损失函数的参数集 \\(W\\) 的过程。
预示:一旦我们理解了这三个核心组件如何相互作用,我们将重新审视第一个组件(参数化函数映射)并将其扩展到比线性映射复杂得多的函数:首先是整个神经网络,然后是卷积神经网络。损失函数和优化过程将保持相对不变。
损失函数的可视化
我们将在此类中看到的损失函数通常是在非常高维的空间上定义的(例如,在 CIFAR-10 中,线性分类器权重矩阵的大小为 [10 x 3073],总共 30,730 个参数),这使得它们难以可视化。然而,我们仍然可以通过沿射线(一维)或沿平面(二维)剖切高维空间来获得一些关于一维的直觉。例如,我们可以生成一个随机权重矩阵\\(W\\)(对应空间中的单个点),然后沿着一条射线行进并记录沿途的损失函数值。也就是说,我们可以生成一个随机方向 \\(W_1\\) 并通过评估 \\(L(W + a W_1)\\) 不同值 \\(a\\) 来计算沿该方向的损失。此过程生成一个简单的图,其中 \\(a\\) 的值作为 x 轴,损失函数的值作为 y 轴。当我们改变 \\(a, b\\) 时,我们还可以通过评估损失 \\( L(W + a W_1 + b W_2) \\) 来对二维执行相同的过程。在图中,\\(a, b\\) 可以对应于 x 轴和 y 轴,并且损失函数的值可以用颜色可视化:
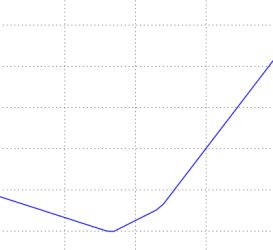
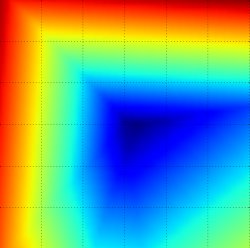
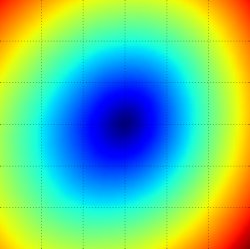
我们可以通过检查数学来解释损失函数的分段线性结构。对于一个例子,我们有:
$$ L_i = \sum_{j\neq y_i} \left[ \max(0, w_j^Tx_i - w_{y_i}^Tx_i + 1) \right] $$
从方程可以清楚地看出,每个示例的数据损失是(由于 \\(\max(0,-)\\) 函数而导致的零阈值)\\(W\\) 线性函数的总和。此外,\\(W\\)(即\\(w_j\\))的每一行有时在其前面有一个正号(当它对应于示例的错误类时),有时有一个负号(当它对应于该示例的正确类时)。为了使这一点更加明确,请考虑一个包含三个一维点和三个类的简单数据集。完整的 SVM 损失(没有正则化)变为:
$$ \begin{align} L_0 = & \max(0, w_1^Tx_0 - w_0^Tx_0 + 1) + \max(0, w_2^Tx_0 - w_0^Tx_0 + 1) \\\\ L_1 = & \max(0, w_0^Tx_1 - w_1^Tx_1 + 1) + \max(0, w_2^Tx_1 - w_1^Tx_1 + 1) \\\\ L_2 = & \max(0, w_0^Tx_2 - w_2^Tx_2 + 1) + \max(0, w_1^Tx_2 - w_2^Tx_2 + 1) \\\\ L = & (L_0 + L_1 + L_2)/3 \end{align} $$
由于这些示例是一维的,因此数据 \\(x_i\\) 和权重 \\(w_j\\) 是数字。例如,看 \\(w_0\\),上面的一些项是 \\(w_0\\) 的线性函数,并且每个项都钳位为零。我们可以将其想象如下:
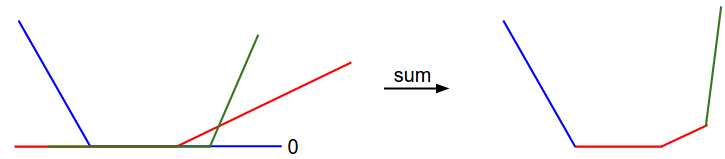
顺便说一句,您可能已经从其碗形外观猜到 SVM 代价函数是凸函数的一个示例。有大量文献致力于有效地最小化这些类型的函数,您也可以参加有关该主题的斯坦福大学课程(凸优化)。一旦我们将得分函数 \\(f\\) 扩展到神经网络,我们的目标函数将变得非凸,并且上面的可视化将不再以碗为特征,而是以复杂、崎岖的地形为特征。
不可微损失函数。作为技术说明,您还可以看到损失函数中的不可导拐点(由于最大值操作)在技术上使损失函数不可微,因为在这些不可导拐点处梯度未定义。然而,次梯度仍然存在并且被广泛使用。在本课程中,将交替使用术语次梯度和梯度。
优化
重申一下,损失函数让我们能够量化任何特定权重集 W 的质量。优化的目标是找到使损失函数最小化的W。我们现在将激励并慢慢开发一种优化损失函数的方法。对于那些有过经验的人来说,这一部分可能看起来很奇怪,因为我们将使用的工作示例(SVM 损失)是一个凸问题,但请记住,我们的目标是最终优化神经网络,而我们无法轻松使用凸优化文献中开发的任何工具。
策略#1:第一个非常糟糕的解决方案:随机搜索
由于检查给定参数集 W 的好坏非常简单,因此可能想到的第一个(非常糟糕的)想法就是简单地尝试许多不同的随机权重并跟踪最有效的方法。此过程可能如下所示:
# assume X_train is the data where each column is an example (e.g. 3073 x 50,000)
# assume Y_train are the labels (e.g. 1D array of 50,000)
# assume the function L evaluates the loss function

bestloss = float("inf") # Python assigns the highest possible float value
for num in range(1000):
  W = np.random.randn(10, 3073) * 0.0001 # generate random parameters
  loss = L(X_train, Y_train, W) # get the loss over the entire training set
  if loss < bestloss: # keep track of the best solution
    bestloss = loss
    bestW = W
  print 'in attempt %d the loss was %f, best %f' % (num, loss, bestloss)

# prints:
# in attempt 0 the loss was 9.401632, best 9.401632
# in attempt 1 the loss was 8.959668, best 8.959668
# in attempt 2 the loss was 9.044034, best 8.959668
# in attempt 3 the loss was 9.278948, best 8.959668
# in attempt 4 the loss was 8.857370, best 8.857370
# in attempt 5 the loss was 8.943151, best 8.857370
# in attempt 6 the loss was 8.605604, best 8.605604
# ... (trunctated: continues for 1000 lines)
在上面的代码中,我们看到我们尝试了几个随机权重向量 W,其中一些比其他的效果更好。我们可以采用此搜索找到的最佳权重 W 并在测试集上进行尝试:
# Assume X_test is [3073 x 10000], Y_test [10000 x 1]
scores = Wbest.dot(Xte_cols) # 10 x 10000, the class scores for all test examples
# find the index with max score in each column (the predicted class)
Yte_predict = np.argmax(scores, axis = 0)
# and calculate accuracy (fraction of predictions that are correct)
np.mean(Yte_predict == Yte)
# returns 0.1555
最好的 W 的准确率约为 15.5%。考虑到完全随机猜测类只能达到 10%,对于这样一个简单直接的随机搜索方案来说,这并不是一个非常糟糕的结果!
核心思想:迭代求精。当然,事实证明我们可以做得更好。核心思想是,找到最好的权重集 W 是一个非常困难甚至不可能的问题(特别是当 W 包含整个复杂神经网络的权重时),但是将一组特定的权重 W 细化为稍微更好的问题则明显不那么困难。换句话说,我们的方法将从随机 W 开始,然后迭代地改进它,每次都稍微好一点。
我们的策略是从随机权重开始,并随着时间的推移迭代地改进它们,以获得更低的损失
蒙住眼睛的徒步旅行者类比。您可能会发现对前进很有帮助的一个类比是,想象自己蒙着眼睛在丘陵地带徒步旅行,并试图到达底部。在 CIFAR-10 的示例中,山丘的维度为 30,730,因为 W 的维度为 10 x 3073。在山丘上的每个点,我们都会实现特定的损失(地形的高度)。
策略#2:随机本地搜索
您可能想到的第一个策略是尝试向随机方向伸出一只脚,然后仅在脚下坡时才迈出一步。具体来说,我们将从随机 \\(W\\) 开始,对其生成随机扰动 \\( \delta W \\),如果扰动 \\(W + \delta W\\) 处的损失较低,我们将执行更新。该过程的代码如下:
W = np.random.randn(10, 3073) * 0.001 # generate random starting W
bestloss = float("inf")
for i in range(1000):
  step_size = 0.0001
  Wtry = W + np.random.randn(10, 3073) * step_size
  loss = L(Xtr_cols, Ytr, Wtry)
  if loss < bestloss:
    W = Wtry
    bestloss = loss
  print 'iter %d loss is %f' % (i, bestloss)
使用与之前相同数量的损失函数评估 (1000),该方法实现了 21.4% 的测试集分类精度。这更好,但仍然很浪费并且计算代价很高。
策略#3:遵循梯度
在上一节中,我们尝试在权重空间中找到一个可以改善权重向量(并降低损失)的方向。事实证明,没有必要随机搜索一个好的方向:我们可以计算最佳方向,沿着该方向我们应该改变我们的权重向量,该向量在数学上保证是最陡下降的方向(至少在步长趋近于零的极限内)。这个方向将与损失函数的梯度相关。在我们的徒步旅行比喻中,这种方法大致相当于感受脚下山坡的坡度,然后沿着感觉最陡的方向走下去。
在一维函数中,斜率是函数在您可能感兴趣的任何点处的瞬时变化率。梯度是不采用单个数字而是采用数字向量的函数斜率的推广。此外,梯度只是输入空间中每个维度的斜率向量(通常称为导数)。一维函数相对于其输入的导数的数学表达式为:
$$ \frac{df(x)}{dx} = \lim_{h\ \to 0} \frac{f(x + h) - f(x)}{h} $$
当感兴趣的函数采用数字向量而不是单个数字时,我们将导数称为偏导数,梯度只是每个维度的偏导数向量。
计算梯度
有两种计算梯度的方法:一种是缓慢、近似但简单的方法(数值梯度),另一种是快速、精确但更容易出错的方法,需要微积分(解析梯度)。我们现在将介绍两者。
用有限差分法数值计算梯度
上面给出的公式允许我们以数值方式计算梯度。这是一个通用函数,它采用函数 f、向量 x 来计算梯度,并返回 f 在 x 处的梯度:
def eval_numerical_gradient(f, x):
  """
  a naive implementation of numerical gradient of f at x
  - f should be a function that takes a single argument
  - x is the point (numpy array) to evaluate the gradient at
  """

  fx = f(x) # evaluate function value at original point
  grad = np.zeros(x.shape)
  h = 0.00001

  # iterate over all indexes in x
  it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
  while not it.finished:

    # evaluate function at x+h
    ix = it.multi_index
    old_value = x[ix]
    x[ix] = old_value + h # increment by h
    fxh = f(x) # evalute f(x + h)
    x[ix] = old_value # restore to previous value (very important!)

    # compute the partial derivative
    grad[ix] = (fxh - fx) / h # the slope
    it.iternext() # step to next dimension

  return grad
按照我们上面给出的梯度公式,上面的代码逐一迭代所有维度,沿该维度进行一个小的变化 h,并通过查看函数变化的程度来计算损失函数沿该维度的偏导数。变量 grad 最终保存完整的梯度。
实际考虑。请注意,在数学公式中,梯度在极限中定义为 h 趋向于零,但实际上,使用非常小的值通常就足够了(例如示例中所示的 1e-5)。理想情况下,您希望使用不会导致数值问题的最小步长。此外,在实践中,使用中心差分公式计算数值梯度通常效果更好: \\( [f(x+h) - f(x-h)] / 2 h \\) 。有关详细信息,请参阅wiki。
我们可以使用上面给出的函数来计算任意点和任意函数的梯度。让我们计算权重空间中某个随机点的 CIFAR-10 损失函数的梯度:
# to use the generic code above we want a function that takes a single argument
# (the weights in our case) so we close over X_train and Y_train
def CIFAR10_loss_fun(W):
  return L(X_train, Y_train, W)

W = np.random.rand(10, 3073) * 0.001 # random weight vector
df = eval_numerical_gradient(CIFAR10_loss_fun, W) # get the gradient
梯度告诉我们损失函数沿每个维度的斜率,我们可以用它来进行更新:
loss_original = CIFAR10_loss_fun(W) # the original loss
print 'original loss: %f' % (loss_original, )

# lets see the effect of multiple step sizes
for step_size_log in [-10, -9, -8, -7, -6, -5,-4,-3,-2,-1]:
  step_size = 10 ** step_size_log
  W_new = W - step_size * df # new position in the weight space
  loss_new = CIFAR10_loss_fun(W_new)
  print 'for step size %f new loss: %f' % (step_size, loss_new)

# prints:
# original loss: 2.200718
# for step size 1.000000e-10 new loss: 2.200652
# for step size 1.000000e-09 new loss: 2.200057
# for step size 1.000000e-08 new loss: 2.194116
# for step size 1.000000e-07 new loss: 2.135493
# for step size 1.000000e-06 new loss: 1.647802
# for step size 1.000000e-05 new loss: 2.844355
# for step size 1.000000e-04 new loss: 25.558142
# for step size 1.000000e-03 new loss: 254.086573
# for step size 1.000000e-02 new loss: 2539.370888
# for step size 1.000000e-01 new loss: 25392.214036
以负梯度方向更新。在上面的代码中,请注意,为了计算 W_new,我们在梯度 df 的负方向上进行更新,因为我们希望损失函数减少而不是增加。
步长的影响。梯度告诉我们函数增长率最陡的方向,但它并没有告诉我们应该沿着这个方向走多远。正如我们将在课程后面看到的,选择步长(也称为学习率)将成为训练神经网络时最重要(也是最令人头痛)的超参数设置之一。在蒙眼下山的比喻中,我们感觉到脚下的山坡向某个方向倾斜,但我们应该采取的步长是不确定的。如果我们小心地挪动脚步,我们可以期望取得一致但非常小的进步(这对应于小步长)。相反,我们可以选择迈出大的、自信的一步,试图更快地下降,但这可能不会有回报。正如您在上面的代码示例中所看到的,在某些时候,当我们“超越”时,迈出更大的一步会带来更高的损失。
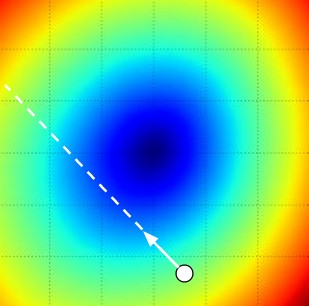
效率问题。您可能已经注意到,评估数值梯度的复杂性与参数数量成线性关系。在我们的示例中,我们总共有 30730 个参数,因此必须对损失函数执行 30,731 次评估来评估梯度并仅执行单个参数更新。这个问题只会变得更糟,因为现代神经网络可以轻松拥有数千万个参数。显然,这个策略不可扩展,我们需要更好的策略。
用微积分分析计算梯度
使用有限差分近似计算数值梯度非常简单,但缺点是它是近似值(因为我们必须选择一个较小的 h 值,而真实梯度定义为 h 趋于零时的极限),并且计算代价非常高。计算梯度的第二种方法是使用微积分进行分析,这使我们能够导出梯度的直接公式(无近似值),并且计算速度也非常快。然而,与数值梯度不同的是,它更容易实现错误,这就是为什么在实践中计算解析梯度并将其与数值梯度进行比较以检查实现的正确性是很常见的原因。这称为梯度检查。
让我们使用单个数据点的 SVM 损失函数示例:
$$ L_i = \sum_{j\neq y_i} \left[ \max(0, w_j^Tx_i - w_{y_i}^Tx_i + \Delta) \right] $$
我们可以根据权重对函数进行微分。例如,取相对于 \\(w_{y_i}\\) 的梯度,我们得到:
$$ \nabla_{w_{y_i}} L_i = - \left( \sum_{j\neq y_i} \mathbb{1}(w_j^Tx_i - w_{y_i}^Tx_i + \Delta > 0) \right) x_i $$
其中 \\(\mathbb{1}\\) 是指示函数,如果内部条件为真,则该函数为 1,否则为 0。虽然表达式在写出来时可能看起来很吓人,但当您在代码中实现它时,您只需计算未满足所需间隔(并因此导致损失函数)的类的数量,然后按此数字缩放的数据向量 \\(x_i\\) 就是梯度。请注意,这只是相对于与正确类别对应的 \\(W\\) 行的梯度。对于 \\(j \neq y_i \\) 的其他行,梯度为:
$$ \nabla_{w_j} L_i = \mathbb{1}(w_j^Tx_i - w_{y_i}^Tx_i + \Delta > 0) x_i $$
一旦导出了梯度的表达式,就可以直接实现这些表达式并使用它们来执行梯度更新。
梯度下降
现在已经能够计算损失函数的梯度。反复计算梯度并据此更新参数的过程称为梯度下降,其基本形式如下:
# Vanilla Gradient Descent

while True:
  weights_grad = evaluate_gradient(loss_fun, data, weights)
  weights += - step_size * weights_grad # perform parameter update
这个简单的循环是所有神经网络库的核心。还有其他执行优化的方法(例如 LBFGS),但梯度下降是目前迄今为止最常见和最成熟的优化神经网络损失函数的方法。在整个课程中,我们将在这个循环的细节上添加一些花哨的内容(例如更新方程的确切细节),但遵循梯度直到我们对结果感到满意的核心思想将保持不变。
小批量梯度下降。在大规模应用中(例如 ILSVRC 挑战),训练数据可能有数百万个示例。因此,为了仅执行单个参数更新而计算整个训练集的完整损失函数似乎很浪费。解决这一挑战的一个非常常见的方法是计算批次训练数据的梯度。例如,在当前最先进的 ConvNet 中,典型的批次包含来自整个 120 万训练集的 256 个示例。然后使用该批处理执行参数更新:
# Vanilla Minibatch Gradient Descent

while True:
  data_batch = sample_training_data(data, 256) # sample 256 examples
  weights_grad = evaluate_gradient(loss_fun, data_batch, weights)
  weights += - step_size * weights_grad # perform parameter update
其效果良好的原因是训练数据中的示例是相关的。要了解这一点,请考虑极端情况,即 ILSVRC 中的所有 120 万张图像实际上仅由 1000 张唯一图像的精确副本组成(每个类别一个图像,或者换句话说,每张图像的 1200 个相同副本)。那么很明显,我们为所有 1200 个相同副本计算的梯度都是相同的,当我们对所有 120 万张图像的数据损失进行平均时,我们将得到完全相同的损失,就像我们只在 1000 个图像的一小部分子集上进行评估一样。当然,在实践中,数据集不会包含重复的图像,来自小批量的梯度是整个目标梯度的良好近似值。因此,在实践中,通过评估小批量梯度以执行更频繁的参数更新,可以实现更快的收敛。
这种情况的极端情况是小批量仅包含单个示例的设置。此过程称为随机梯度下降 (SGD)(有时也称为在线梯度下降)。这种情况相对不太常见,因为在实践中,由于向量化代码优化,评估 100 个示例的梯度比评估一个示例的梯度 100 次在计算上要高效得多。尽管 SGD 在技术上指的是一次使用单个示例来评估梯度,但即使在提到小批量梯度下降时,您也会听到人们使用术语 SGD(即很少看到提及 MGD 表示“小批量梯度下降”,或 BGD 表示“批量梯度下降”),通常假设使用小批量。小批量的大小是一个超参数,但交叉验证它并不常见。它通常基于内存限制(如果有),或设置为某个值,例如32、64 或 128。我们在实践中使用 2 的幂,因为许多向量化运算实现在其输入大小为 2 的幂时工作得更快。
小结
在这个部分,
- 我们将损失函数的直觉发展为一个高维优化曲面,我们试图在其中到达底部。我们建立的有效类比是一个蒙着眼睛的徒步旅行者希望到达底部。特别是,我们看到 SVM 代价函数是分段线性且碗形的。
- 我们提出了优化损失函数的想法 迭代细化,我们从一组随机权重开始,逐步细化它们,直到损失最小化。
- 我们看到函数的梯度给出了最陡的上升方向,并且我们讨论了一种使用有限差分近似进行数值计算的简单但低效的方法(有限差分是用于计算数值梯度的h的值)。
- 我们看到参数更新需要对步长(或学习率)进行棘手的设置,并且必须设置得恰到好处:如果太低,则进度会稳定但缓慢。如果太高,进展可能会更快,但风险更大。我们将在以后的章节中更详细地探讨这种权衡。
- 我们讨论了计算数值和分析梯度之间的权衡。数值梯度很简单,但它是近似的并且计算代价昂贵。解析梯度是精确的,计算速度快,但更容易出错,因为它需要用数学推导梯度。因此,在实践中,我们总是使用解析梯度,然后执行梯度检查,其中将其实现与数值梯度进行比较。
- 我们引入了梯度下降算法,该算法迭代计算梯度并在循环中执行参数更新。
即将推出:本节的核心要点是计算损失函数相对于其权重的梯度的能力(并对它有一些直观的理解)是设计、训练和理解神经网络所需的最重要的技能。在下一节中,我们将熟练使用链式法则(也称为反向传播)分析计算梯度。这将使我们能够有效地优化表达各种神经网络(包括卷积神经网络)的相对任意的损失函数。